【ブログ】<推論時代の最適解>アプライド×MSIのNVIDIA MGXによるベストフィット提案

アプライド株式会社
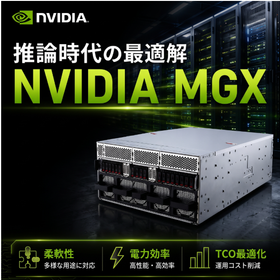
ChatGPTをはじめとするLLM(大規模言語モデル)の実用化が急速に進む中、AIインフラに求められる要件も大きく変化しつつあります。 これまでのAI開発、特に「学習(トレーニング)」のフェーズにおいては、とにかく最高性能のGPUをかき集め、GPUメモリの速度と容量を追求する巨額なデータセンター投資が主流でした。 しかし、モデルが完成し、実際の業務やサービスで活用する「推論(インファレンス)」のフェーズに移行していく中で、新たな課題が浮き彫りになっています。 それは、「学習用の最高峰システム(DGXやHGX)をそのまま推論に使うのは、多くの場合オーバースペックであり、初期投資もランニングコストも過剰になってしまう」という問題です。 これからの推論インフラに求められるのは、単なる「最高性能」ではなく、用途に応じた「柔軟性」と「電力効率」です。 今回は、データセンターのTCO(総所有コスト)を最適化し、無駄のない推論基盤を実現する「NVIDIA MGX」アーキテクチャと、 アプライドが提案するベストフィットなサーバー構成について解説します。