NVIDIA HGX B300 8GPU AIサーバー


GPUメモリ2TB超×高速NVLink!大規模LLM推論・生成AI開発を加速
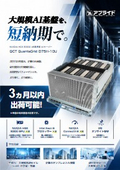
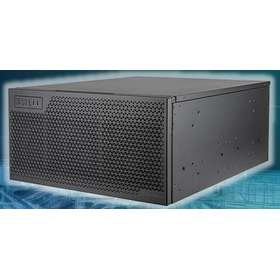
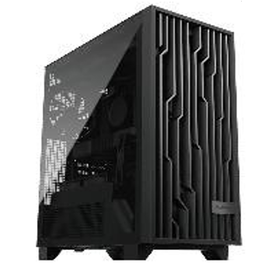
NVIDIA HGX B300は、Blackwell Ultra GPUを8基搭載した、大規模AI・生成AI開発向けの高性能GPUプラットフォームです。 GPU1基あたり270GB、8基合計2,160GBの大容量HBM3eメモリを備え、第5世代NVLink/NVSwitchによるGPU間高速通信に対応。大規模言語モデル(LLM)の推論、長文RAG、AIエージェント、マルチモーダルAIなど、大容量メモリと高い演算性能が求められる処理を支援します。 アプライドでは、QCT製「QuantaGrid D75H-10U」をベースとしたHGX B300搭載8GPUサーバーをご提案。空冷10Uラックマウント構成により、AI研究開発から企業内の大規模AI基盤構築まで幅広く対応します。最短約3か月での導入もご相談可能です。
基本情報
【QCT QuantaGrid D75H-10U 構成例】 ■GPU:NVIDIA HGX B300(Blackwell Ultra GPU×8基) ■GPUメモリ:270GB HBM3e×8基(合計2,160GB) ■GPUメモリ帯域:最大7.7TB/s(1GPUあたり公称値) ■GPU間通信:第5世代NVLink/NVSwitch(1GPUあたり最大1.8TB/s) ■CPU:Intel Xeon 6788P×2基(各86コア/172スレッド) ■メモリ:128GB/2TB構成例 ■ストレージ:M.2 SSD 1.92TB×2基 ■ネットワーク:NVIDIA ConnectX-8×8基、800Gb/s Ethernet/InfiniBand対応 ■筐体:10Uラックマウント型・空冷方式 ■保守:3年間オンサイト保守 ※構成・仕様・納期は導入条件により異なります。
価格帯
納期
用途/実績例
【大規模LLM・生成AI開発】 DeepSeek-R1などの大規模MoEモデルをはじめ、GPUメモリを大量に消費するLLMの推論・評価・追加学習に活用できます。 【企業内RAG・AIエージェント】 長文技術文書の検索・要約、社内ナレッジ活用、多数ユーザーによる同時AI利用など、高い推論処理能力が必要なシステムに対応します。 【画像AI・マルチモーダル解析】 VLM(視覚言語モデル)、画像認識AI、画像と文章を組み合わせたAIモデルの研究開発や追加学習に適しています。 【研究機関・企業向けAI基盤】 大学・研究機関、製造業、AI開発企業などでのオンプレミスAI基盤構築に活用可能。複数GPUを連携させた大規模モデル処理や、複数サーバーへの拡張にも対応します。